중간고사
-
무작위 표본 X_i는 1과 \theta에서 균등분포를 따른다. \theta의 적률법에 의한 추정량과 최대우도추정량을 구하고 이들을 비교하시오. 단, i=1,2,3,….,n이고 \theta > 1이다.
-
확률변수 X_i는 기댓값과 분산이 각각 \mu와 \sigma^2 인 정규분포를 따른다. 모평균 \mu가 알려진 경우 \sigma^2의 최대우도추정량의 분산을 구하시오. 단, i=1,2,3,….,n이다.
-
기댓값이 \mu이고 분산이 100인 정규분포에서 10개의 표본을 추출하여 \mu를 추정하고자 한다.
과거 경험에 의하면 \mu는 10에서 15 사이이고 모든 값이 동일한 가능성을 갖는다. 모평균 \mu의 Bayes estimator를 구하시오. -
정규모집단에서 다음과 같은 표본을 구했다. 모평균의 95% 신뢰구간을 자세히 설명하시오.
45,~20,~10,~12,~25힌트 : t_{0.025}(5) = 2.571
기말고사
중간고사 해답
중간고사 해답 보기
1. 균등분포 \theta의 적률법 추정량과 최대우도추정량
X_i\overset{\mathrm{iid}}\sim\text{Uniform}(1,\theta), \theta>1, i=1,\ldots,n이고 밀도는
이다.
적률법(MoM). E[X]=\dfrac{1+\theta}{2}이므로 표본적률과 모적률을 같다고 놓으면
이다.
최대우도추정량(MLE). 가능도함수는
이다. \theta>\max_i x_i인 범위에서 L(\theta)는 \theta에 대해 감소함수이므로 가능도를 최대화하는 \theta는 그 범위의 가장 작은 값이다. 즉
이다.
두 추정량의 비교. \tilde\theta_{MoM}=2\bar X-1은
이므로 불편추정량이고,
이므로
이다. 한편 X_{(n)}의 분포함수는 1<t<\theta에서 F_{(n)}(t)=\left(\dfrac{t-1}{\theta-1}\right)^{n}이고, u=t-1로 치환해 직접 적분하면(균등분포 최댓값의 표준 결과)
를 얻는다. 따라서 \hat\theta_{MLE}는 편향
을 갖는 편의추정량이지만 n\to\infty일 때 편향이 0으로 사라지고,
이다. 두 MSE의 비를 보면
이 되어, MLE는 편의추정량임에도 MoM 추정량보다 훨씬 빠른 O(1/n^2) 수렴 속도를 가져 평균제곱오차 기준으로 훨씬 우수하다. 지지집합의 끝점이 모수 \theta에 의존하는 비정칙(non-regular) 모형이라 MLE가 통상적인 O(1/n)의 효율 한계를 넘어서는 경우다.
2. 정규분포 분산의 최대우도추정량의 분산
X_i\overset{\mathrm{iid}}\sim N(\mu,\sigma^2), \mu는 알려져 있다, i=1,\ldots,n. 최대우도추정량은
이다. Z_i=(X_i-\mu)/\sigma\overset{\mathrm{iid}}\sim N(0,1)이라 하면
이고 \operatorname{Var}(\chi^2_n)=2n이므로
이다.
3. Bayes estimator
X_i\mid\mu\overset{\mathrm{iid}}\sim N(\mu,100), i=1,\ldots,n=10이고, 사전분포는 \mu\sim\text{Uniform}(10,15), 즉 \pi(\mu)=\dfrac15I(10<\mu<15)이다.
가능도는
이다(\sum(x_i-\mu)^2=\sum(x_i-\bar x)^2+n(\bar x-\mu)^2에서 \mu와 무관한 항을 뺐다). 이는 \mu에 대해 평균 \bar x, 분산 \sigma^2/n=100/10=10인 정규분포의 커널과 같다. 사전분포가 (10,15)에서 균등이므로 사후분포는
즉 평균 \bar x, 분산 10인 정규분포를 (10,15) 구간으로 절단한 절단정규분포(truncated normal)다.
제곱오차손실 하에서 베이즈 추정량은 사후평균이다. 절단정규분포의 평균 공식(평균 \mu_0, 표준편차 \sigma_0인 정규분포를 (a,b)로 절단하면 E[Y]=\mu_0+\sigma_0\dfrac{\phi(\alpha)-\phi(\beta)}{\Phi(\beta)-\Phi(\alpha)}, \alpha=(a-\mu_0)/\sigma_0, \beta=(b-\mu_0)/\sigma_0)에 \mu_0=\bar x, \sigma_0=\sqrt{10}, a=10, b=15를 대입하면
이다. \phi,\Phi는 각각 표준정규분포의 밀도함수와 분포함수다. 표본평균 \bar x가 (10,15) 안쪽 깊숙이 있고 사후표준편차 \sqrt{10}\approx3.16에 비해 경계까지 충분히 멀면 절단의 효과가 작아져 \hat\mu_{Bayes}\approx\bar x에 가까워진다.
4. 모평균의 95% 신뢰구간
자료는 45,\ 20,\ 10,\ 12,\ 25이고 n=5다.
모분산을 모르는 정규모집단에서 모평균의 100(1-\alpha)\% 신뢰구간은 자유도 n-1=4인 t분포를 써서
이다. 여기서 힌트로 주어진 값은 t_{0.025}(5)=2.571인데, 이 값은 자유도가 5일 때의 값이다(n=5에서 정석대로라면 자유도는 n-1=4이고 t_{0.025}(4)=2.776이다). 아래에서는 문제가 제시한 힌트값을 그대로 써서 계산한다.
이므로 95% 신뢰구간은
이다. 이 구간의 해석은 다음과 같다: 같은 방식으로 표본을 반복해서 뽑아 신뢰구간을 만드는 절차를 무한히 반복하면, 그렇게 만들어진 구간들 중 약 95%가 모평균 \mu의 참값을 포함한다는 뜻이다. 하나의 표본에서 얻은 이 특정 구간이 95%의 확률로 \mu를 포함한다는 뜻이 아니다.
기말고사 해답
기말고사 해답 보기
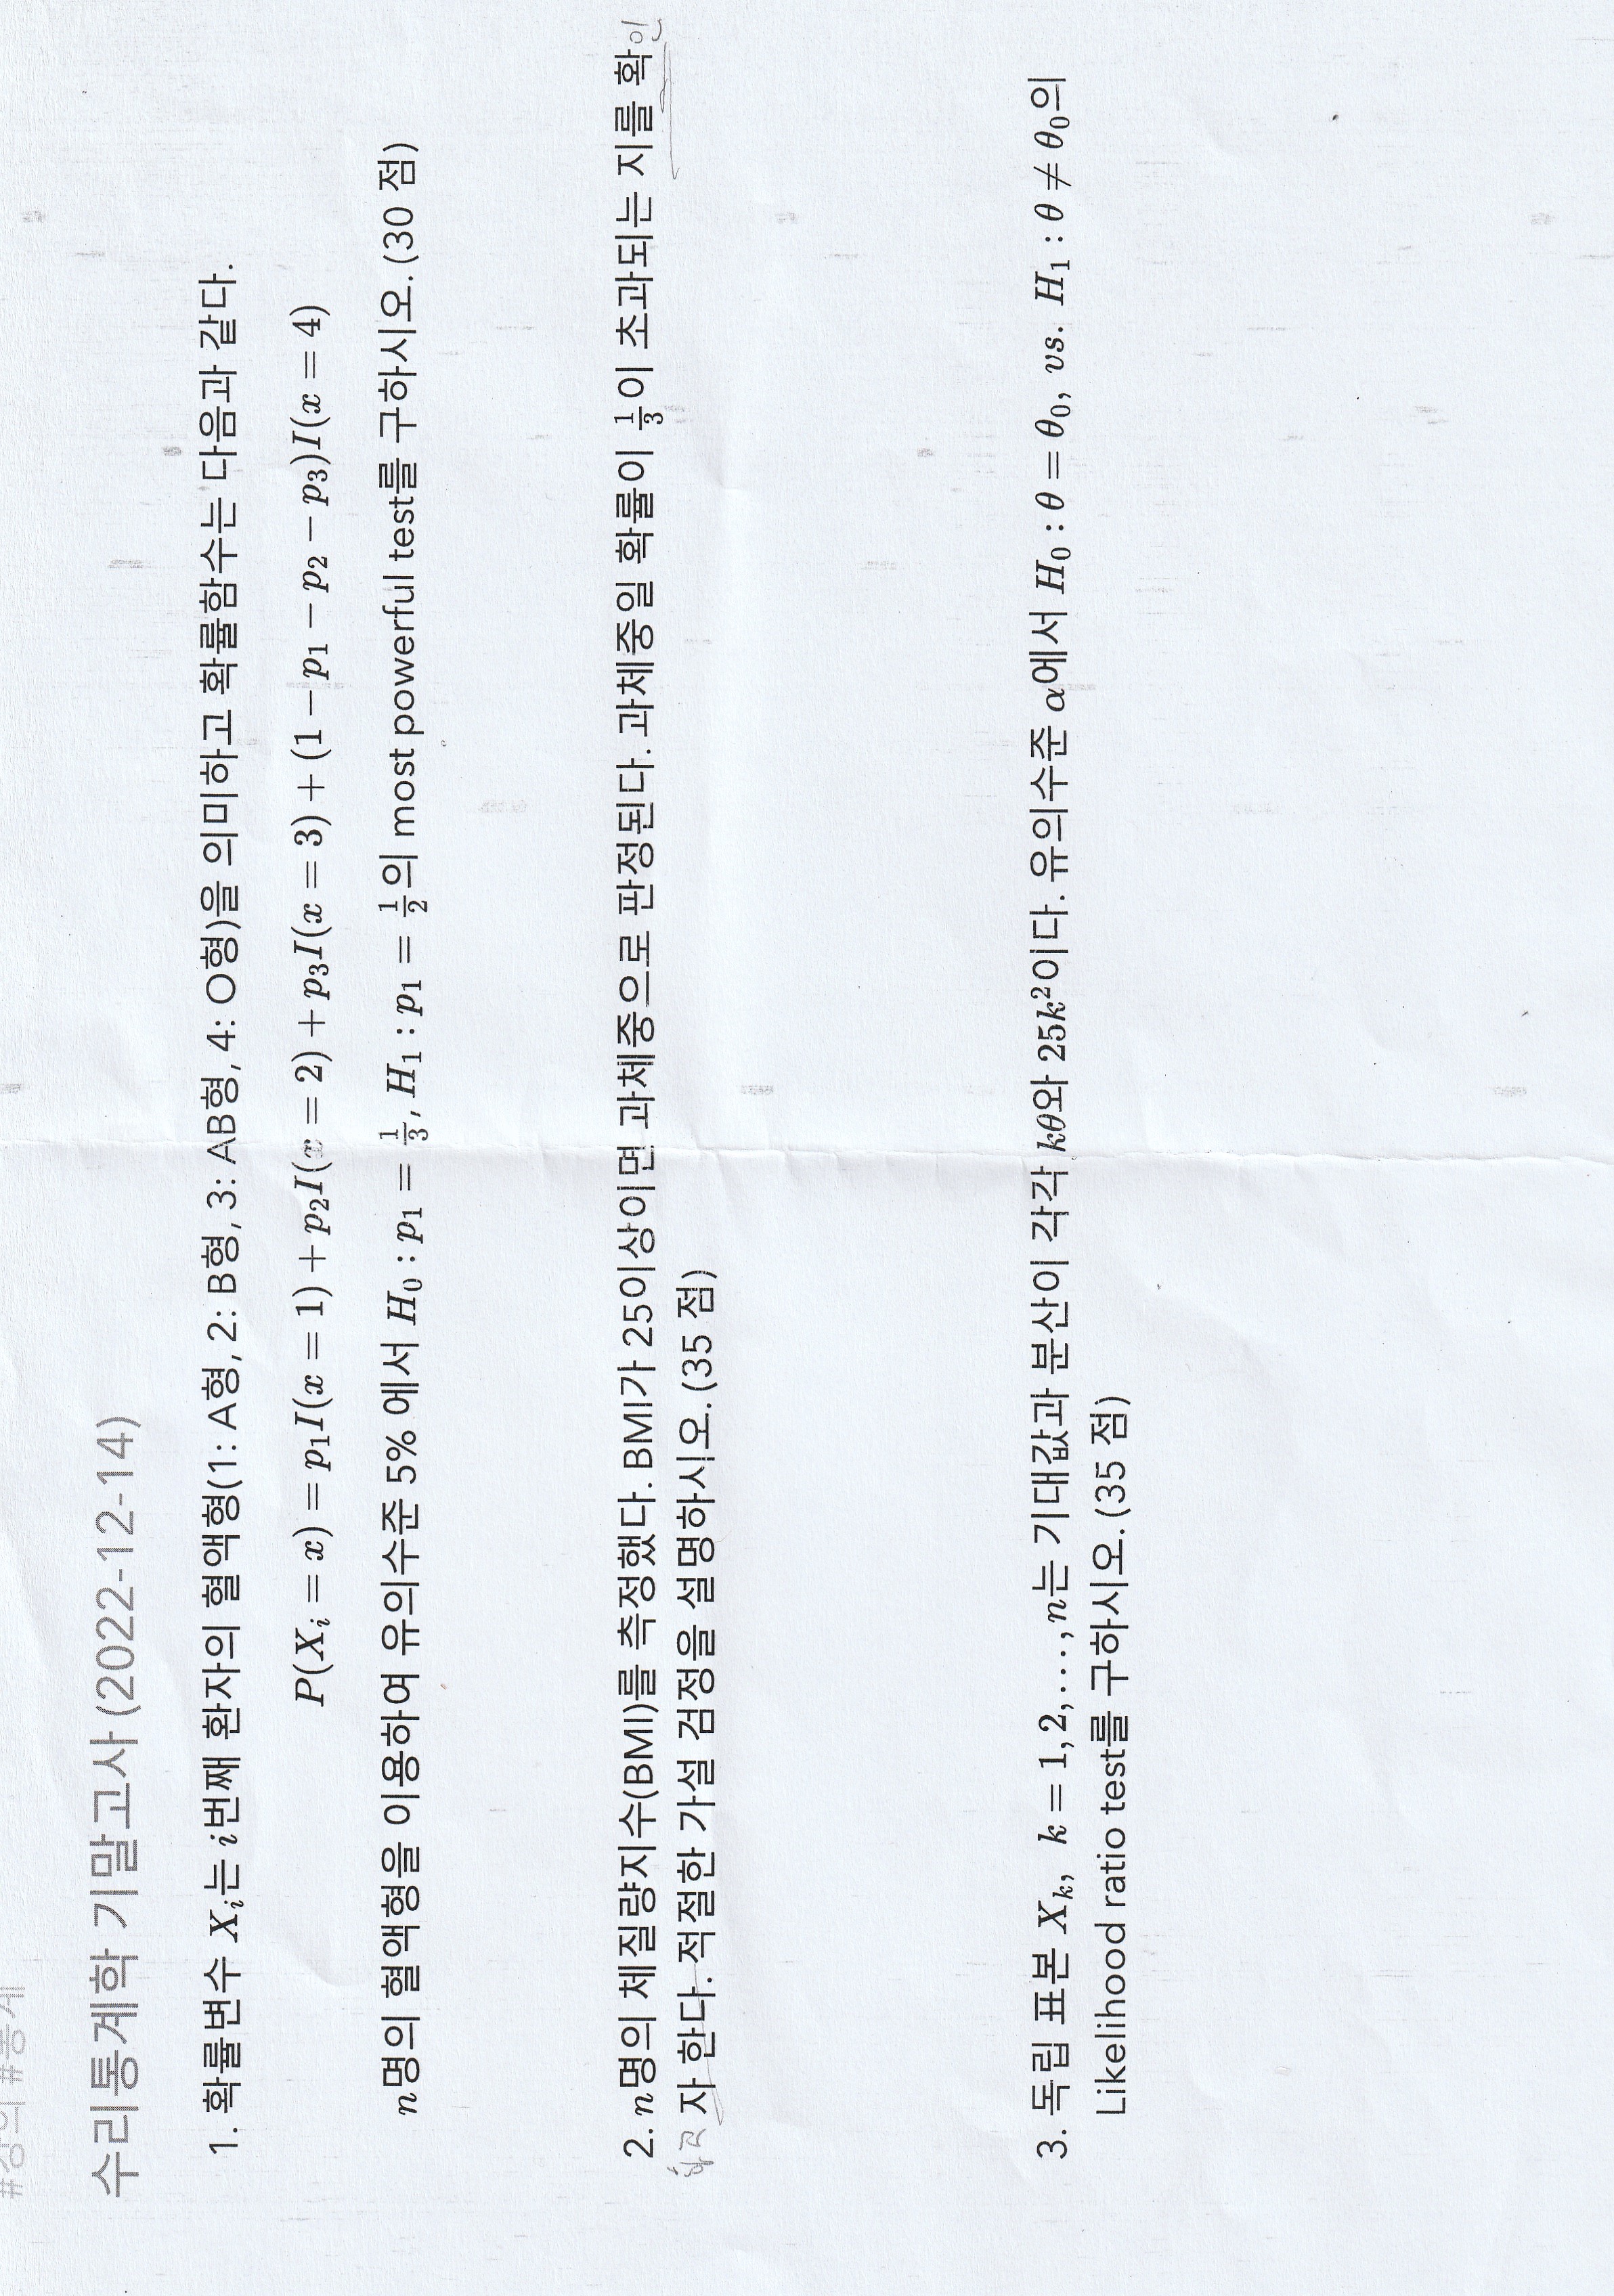
1. 혈액형 자료의 최강력검정(Most Powerful Test)
확률변수 X_i는 i번째 환자의 혈액형(1: A형, 2: B형, 3: AB형, 4: O형)이고
이다. X_1,\ldots,X_n은 서로 독립이고, 검정하려는 가설은
이다. p_2,p_3는 두 가설 모두에서 값이 바뀌지 않는 성가신 모수로 둔다.
Y_i=I(X_i=1)(환자가 A형인지 여부)라 하면, X_i\neq1일 때 그 조건부 분포(B형·AB형·O형 사이의 비율)는 p_1과 무관한 상수이므로 전체 가능도는
로 인수분해된다. 여기서 C=\prod_{i:x_i\neq1}q_{x_i}(q_2,q_3,q_4는 A형이 아닐 때의 조건부 확률)는 p_1과 무관한 상수다. T=\sum_{i=1}^nY_i(A형 환자의 수)라 하면
이다. Neyman–Pearson 정리에 의해 최강력검정은 가능도비
가 클 때 H_0를 기각한다. \Lambda(\mathbf x)는 T에 대해 증가함수이므로 기각역은 T\ge c 꼴이다:
c는 H_0 하에서 T\sim\text{Binomial}(n,1/3)이고 P_{p_1=1/3}(T\ge c)=0.05가 되도록 정한다. n이 커서 정규근사를 쓰면 E_{H_0}[T]=n/3, \operatorname{Var}_{H_0}(T)=n\cdot\frac13\cdot\frac23=\frac{2n}{9}이므로
이다. \Lambda(\mathbf x)가 T에 대해 단조증가하므로 이 검정은 H_1의 특정값 p_1=1/2에 의존하지 않고 p_1>1/3인 모든 값에 대해 최강력이다. 즉 단조가능도비(MLR) 성질에 의해 Karlin–Rubin 정리로 H_0:p_1\le1/3 vs H_1:p_1>1/3에 대한 균등최강력검정(UMP test)이기도 하다.
2. 과체중 비율에 대한 가설검정
Y_i=I(\text{BMI}_i\ge25)(과체중 여부), i=1,\ldots,n은 서로 독립이고 \text{Bernoulli}(p)를 따른다. 단, p=P(\text{과체중})이다. 과체중일 확률이 1/3을 초과하는지 확인하려는 것이므로
인 단측검정을 구성한다. 이항분포족 \{\text{Bernoulli}(p)\}는 위 1번 문제와 같은 방식으로 T=\sum_{i=1}^nY_i에 대해 단조가능도비(MLR)를 가지므로, Karlin–Rubin 정리에 의해 수준 \alpha의 균등최강력검정이 존재하고 그 형태는
이다. c는 경계값 p=1/3에서 P(T\ge c)=\alpha가 되도록 정한다(경계에서 크기를 \alpha로 맞추면 p<1/3인 모든 점에서 검정의 크기가 \alpha 이하가 된다).
n이 크면 정규근사를 써서 \hat p=T/n이라 할 때 검정통계량을
로 두고,
이다(예를 들어 \alpha=0.05이면 z_{0.05}=1.645). 표본에서 관측된 과체중 비율 \hat p가 1/3보다 충분히 크면 "과체중일 확률이 1/3을 초과한다"는 H_1을 채택한다.
3. 가능도비 검정(Likelihood Ratio Test)
X_k, k=1,\ldots,n은 서로 독립이고 E[X_k]=k\theta, \operatorname{Var}(X_k)=25k^2\theta^2(\theta>0)이다. 분포의 구체적인 형태가 별도로 주어지지 않았으므로, 주어진 평균·분산만으로 가능도를 구성할 수 있는 가장 표준적인 가정인 정규분포를 따른다고 둔다:
W_k=X_k/k라 하면
로 k에 무관하다. 즉
이다. \overline W=\frac1n\sum_{k=1}^nW_k, \overline{W^2}=\frac1n\sum_{k=1}^nW_k^2라 두면 로그가능도는
이다(상수항은 \theta와 무관하다).
MLE. \ell'(\theta)=0을 풀면
이고, 양변에 \theta^3을 곱해 정리하면
이다. 이 이차방정식의 두 근의 곱은 -\overline{W^2}/25\le0이므로 부호가 다른 두 실근을 갖는다. \theta>0을 가정했으므로 양의 근을 취하면
를 얻는다.
가능도비 검정통계량. 가능도비는
이고, 모수가 1차원이므로 Wilks 정리에 의해 H_0 하에서
로 점근분포한다. \ell(\theta)의 식을 대입해 정리하면
이다. 따라서 유의수준 \alpha에서 가능도비 검정의 기각역은
이다. 여기서 W_k=X_k/k, \overline W=\frac1n\sum_kW_k, \overline{W^2}=\frac1n\sum_kW_k^2, \hat\theta는 위에서 구한 MLE이고 \chi^2_{1,\alpha}는 자유도 1인 카이제곱분포의 100(1-\alpha) 백분위수다.